 AI API 中转站 · 文档
如何查看模型定价、模型名称和扣费记录
最后更新:
「模型广场」就是定价表。它回答三个问题:有哪些模型、模型 ID 怎么写、多少钱。不用登录也能看:https://ai-api.site/pricing
模型广场一览
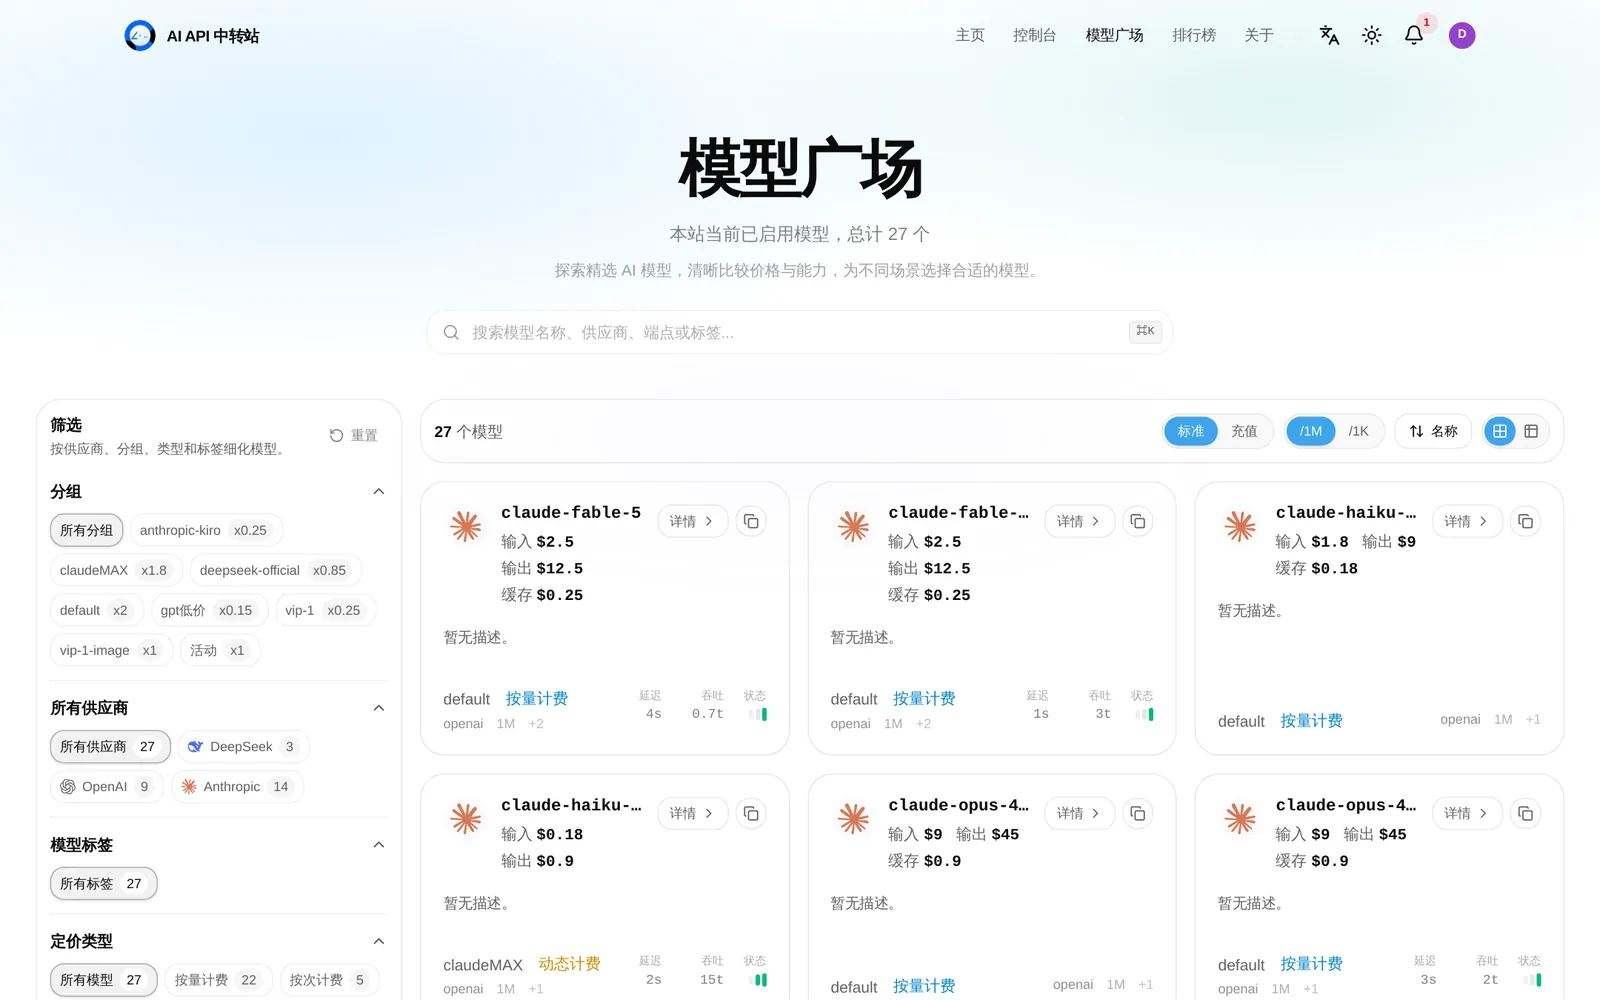
- 分组:按分组筛选,按钮上写着倍率(如
claudeMAX x2)。 - 供应商:Anthropic(Claude)、OpenAI(GPT / 生图)、DeepSeek。
- 定价类型:「按量计费」按 token 收费;「按次计费」每次请求固定价格(生图模型)。
- /1M、/1K:价格单位切换,默认每 100 万 token(1M)。
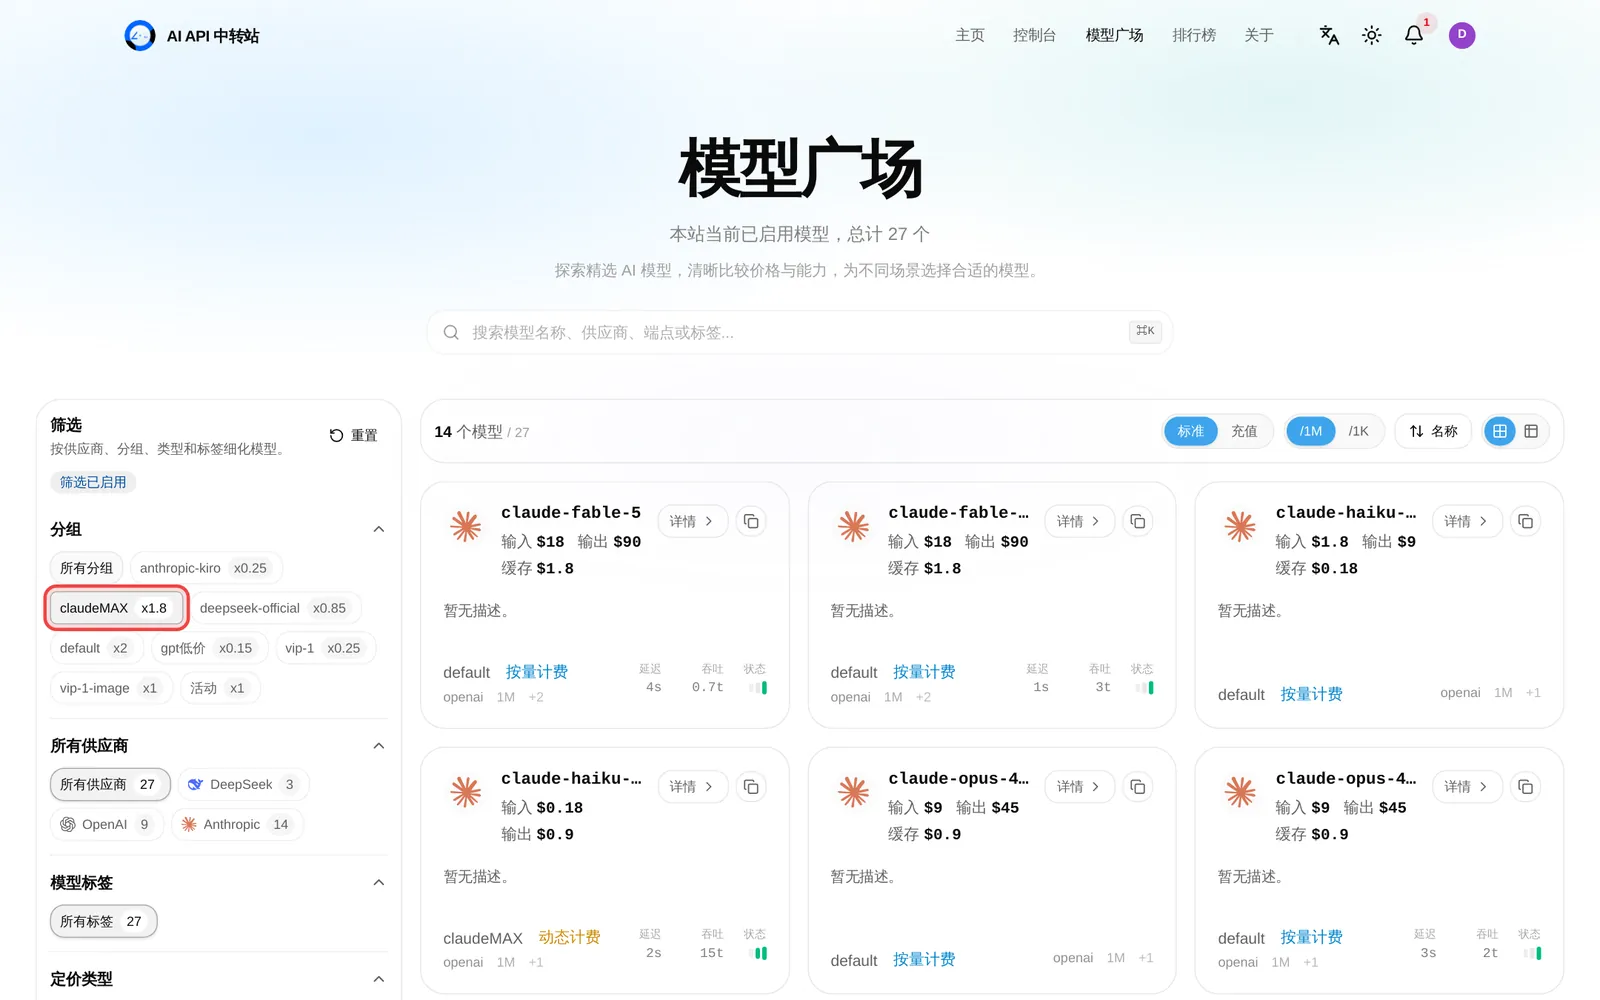
第 1 步:按你 Key 的分组筛选
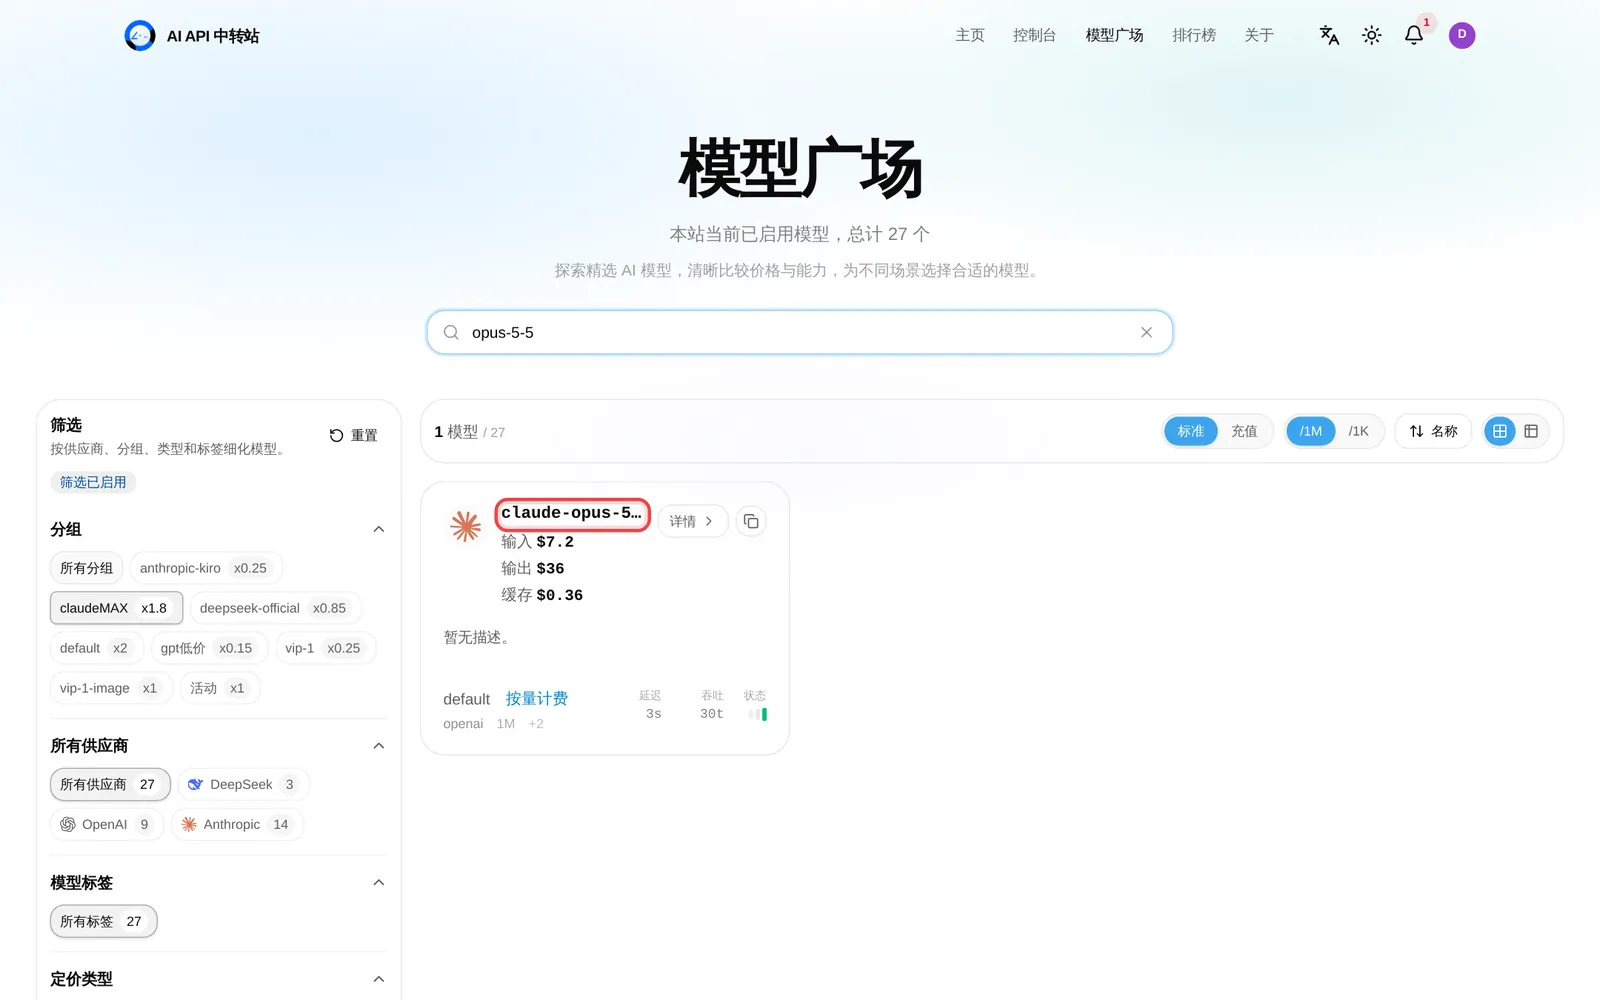
点左侧「分组」里你 Key 所属的分组,列表里就只剩这个分组能用的模型。不在列表里的模型,用这个 Key 调不了。
第 2 步:找到并复制模型 ID
每张卡片上加粗的等宽字就是模型 ID(模型名称),例如 claude-opus-5-5。在客户端里「模型 ID / Model」一栏必须填这个,大小写、横杠、点都要完全一致。可以在搜索框里输入关键字快速定位。
| ✅ 正确 | ❌ 常见错误 | 原因 |
|---|---|---|
claude-opus-5-5 | claude-opus-5.5、Claude Opus 5.5 | Claude 用横杠,不是点;不能有空格 |
gpt-6.1-sol | gpt-6-1-sol、GPT-6.1 | GPT 这里用点;不能省略后缀 |
claude-haiku-4-5-20251001 | claude-haiku-4-5 | 部分模型带日期后缀,要写完整 |
deepseek-flash | deepseek-chat | 本站没有官方旧名,按模型广场写 |
提示
「显示名」可以随便写(比如「Opus 5.5」),但「模型 ID」不行。很多客户端把两者放在一起,注意区分。
第 3 步:点「详情」看具体价格
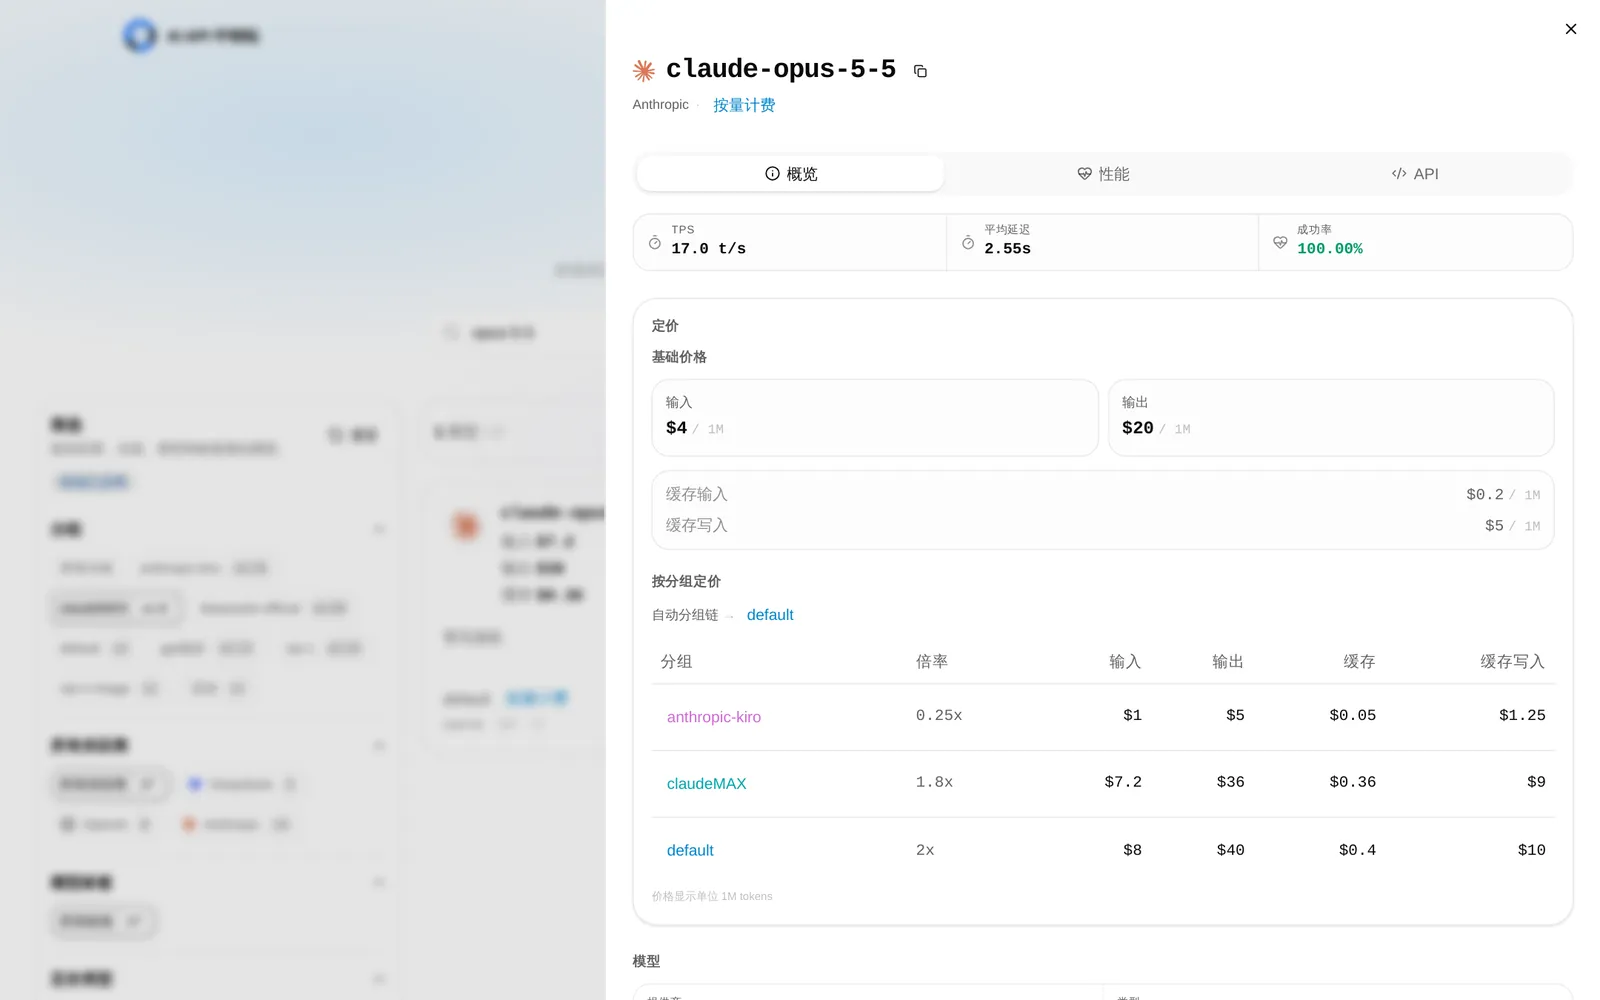
点模型卡片上的 详情,弹窗里有:
- 基础价格:输入、输出、缓存输入(命中缓存的输入)、缓存写入。
- 按分组定价:每个分组乘上倍率之后的实际价格——直接看你那个分组的那一行就行。
- 性能:近期的速度、延迟、成功率。
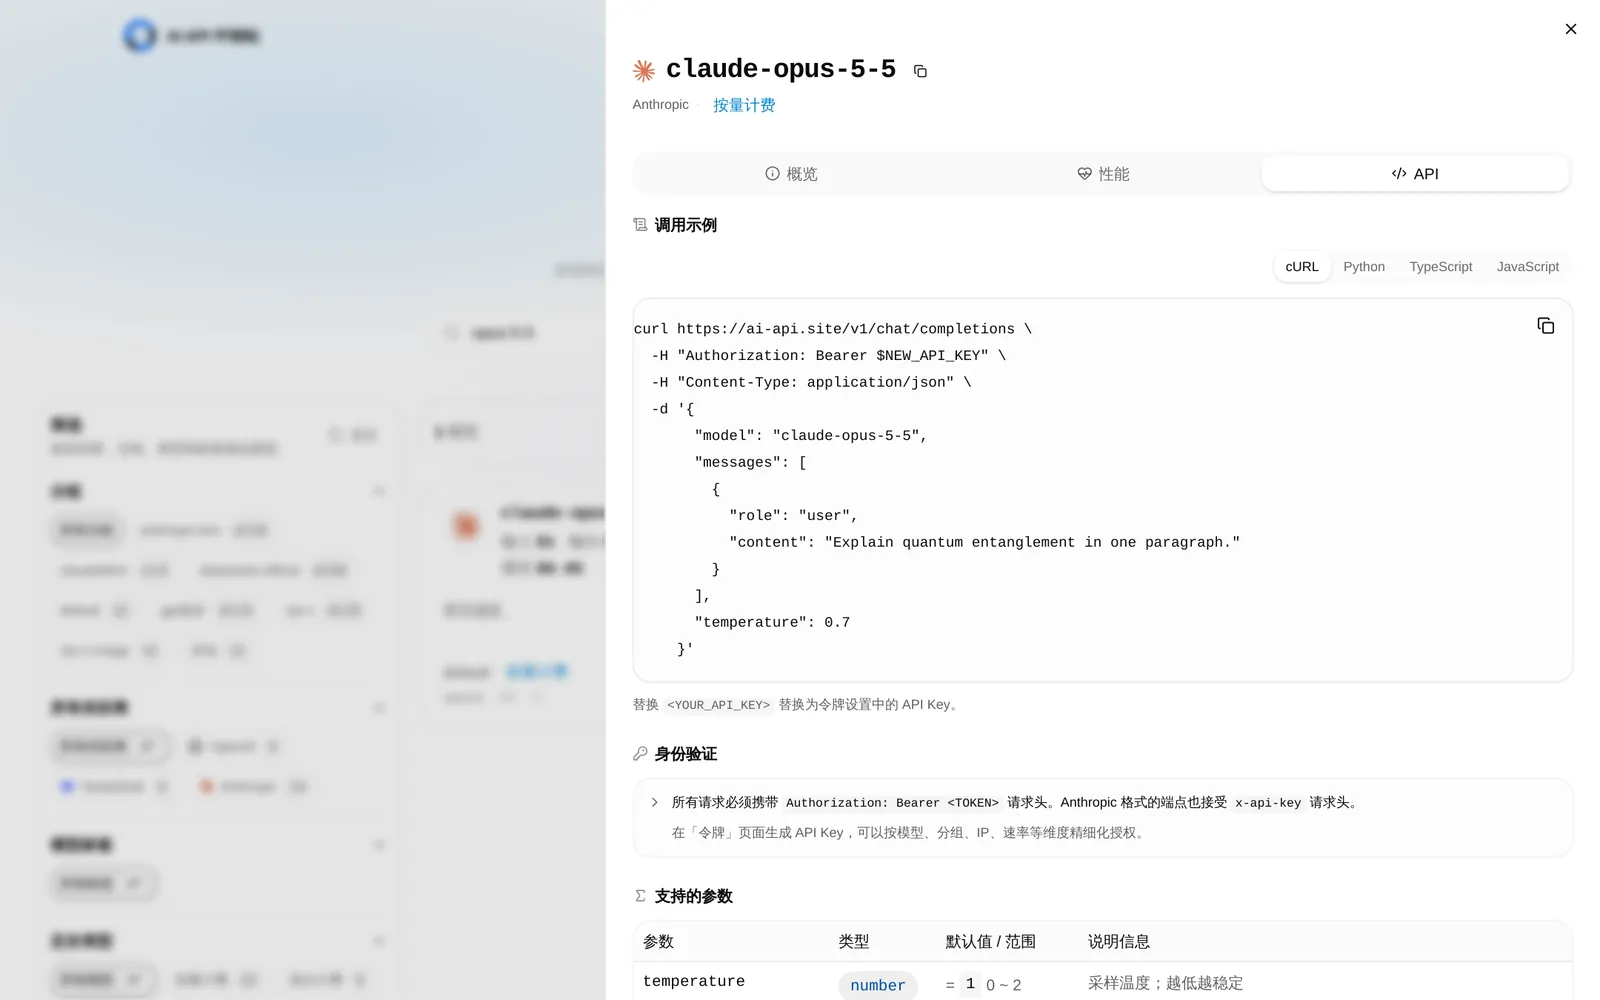
「API」标签页里有现成的 cURL / Python / JavaScript 调用示例,模型 ID 已经帮你填好了:
价格怎么算?
实际费用 = 基础价格 × 分组倍率 × 用量
以某个 Claude 模型为例,基础价格输入 $10 / 1M、输出 $50 / 1M:
| 分组 | 倍率 | 输入 / 1M | 输出 / 1M | 缓存读取 / 1M |
|---|---|---|---|---|
| anthropic-kiro | 0.25× | $2.5 | $12.5 | $0.25 |
| claudeMAX | 2× | $20 | $100 | $2 |
| default | 2× | $20 | $100 | $2 |
- 输入:你发过去的内容(含系统提示词、历史对话、文件)。Agent 每轮都会把上下文发一遍,所以输入通常远多于输出。
- 输出:模型生成的内容(含思考过程)。
- 缓存读取:重复的上下文命中缓存后按很低的价格计费,Claude Code、Codex 这类 Agent 大部分输入都会命中缓存。
- 缓存写入:第一次写入缓存的部分,略贵于普通输入。
- 阶梯价:部分 GPT 模型上下文超过 272K 后单价更高,详情页会写明。
- 时段价:
deepseek-flash在工作日 9:00–12:00、14:00–18:00(北京时间)价格 ×2,其余时间原价。 - 按次计费:生图模型每次请求固定价格,与 token 无关。
提示
页面价格以 $ 显示,本站充值 ¥1 = $1 额度,可以直接把 $ 当成人民币来理解。实际以钱包页显示为准。
查看余额和每次扣费
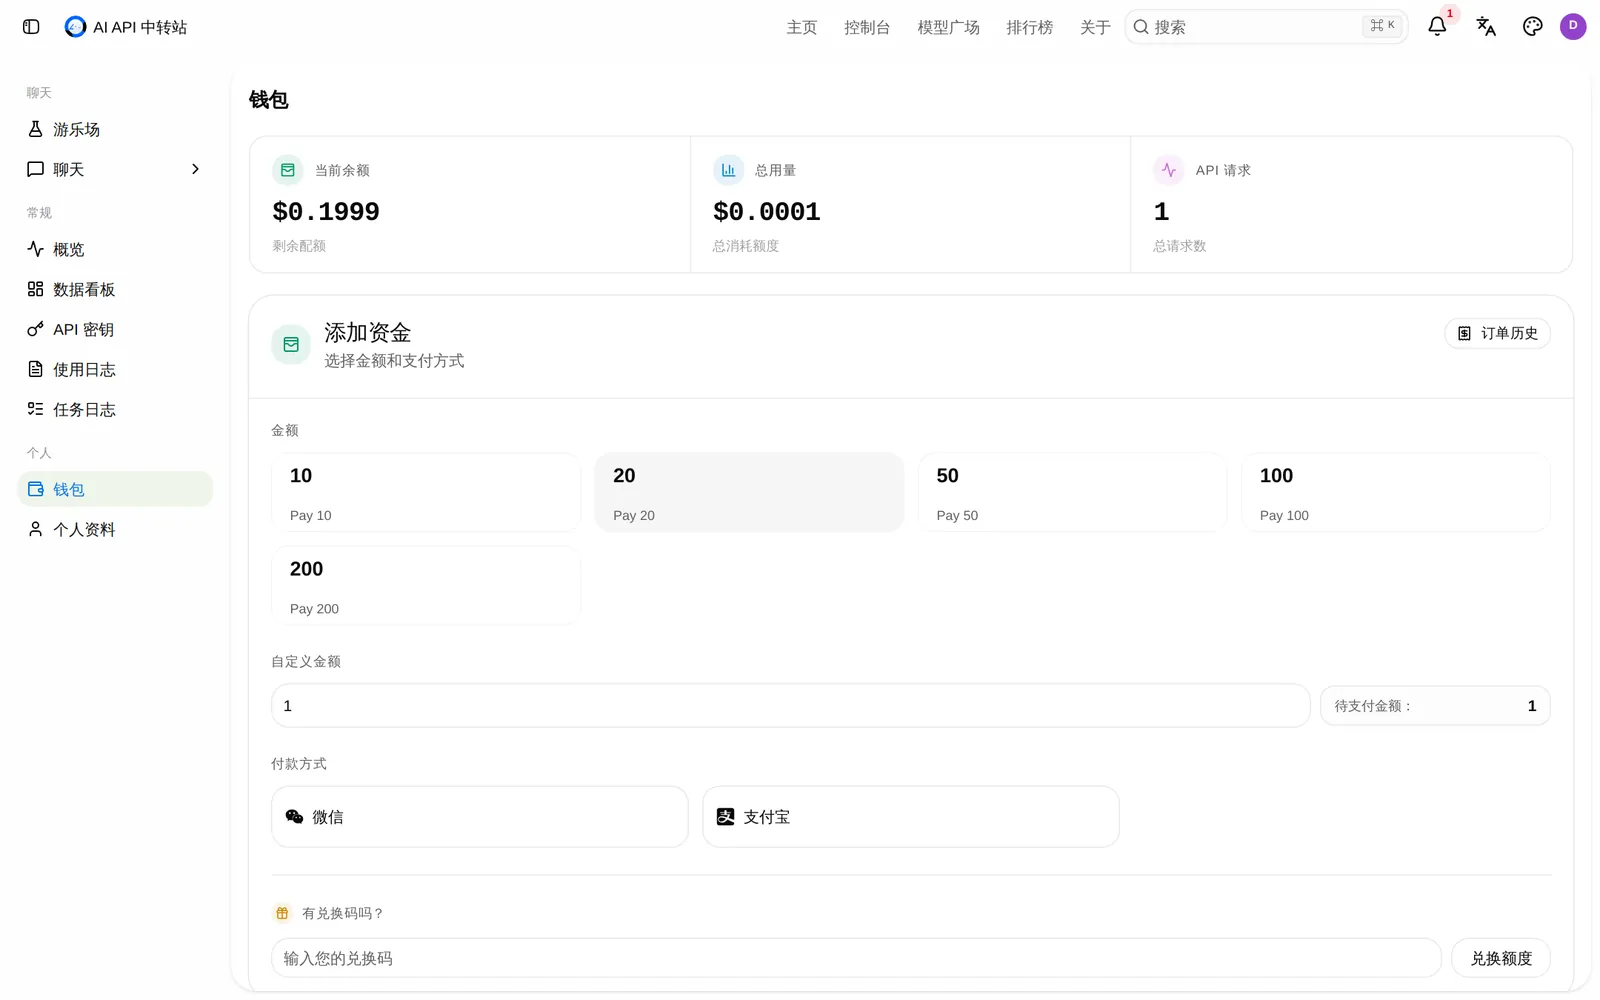
控制台 → 钱包:当前余额、总用量、请求次数,以及充值入口。
控制台 → 使用日志:每一次请求的模型、输入 / 输出 / 缓存 token 数、花费、耗时都有记录。对账、排查「为什么扣这么多」都看这里。